现象:服务才起来几十秒就又断了
这是后台服务最常见的报错姿势:刚连上能用,过一会儿 AI 开始报 Connection error,回头看服务进程,pid 换了,日志里一串 kill -9。
多数人会顺着「服务不稳定」这个方向查——内存、并发、日志太大。但这次不是服务的问题:服务一直是活的,是健康检查判定它死了,然后亲手把它杀了。
服务活着,检查说死了。这种时候先别查服务,去查那个下判断的东西。
第一步:把自启脚本里的健康检查挖出来
开机自启脚本里负责判活的是几行 curl。把里面出现过的地址全列出来:
看着没问题——两行都写着 http://127.0.0.1:5068/api/health。
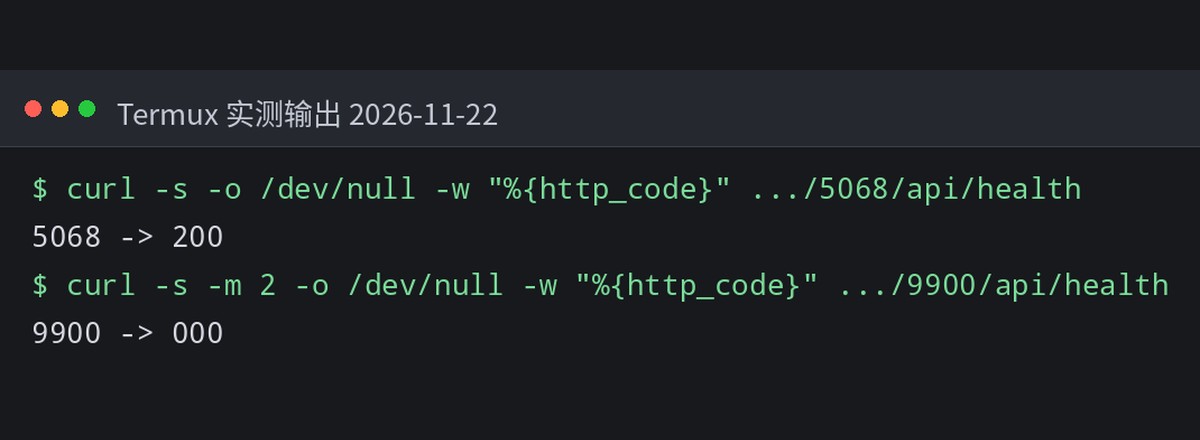
但改之前不是这样。改之前这两行写的是 9900。而服务的真实端口,是 5068。
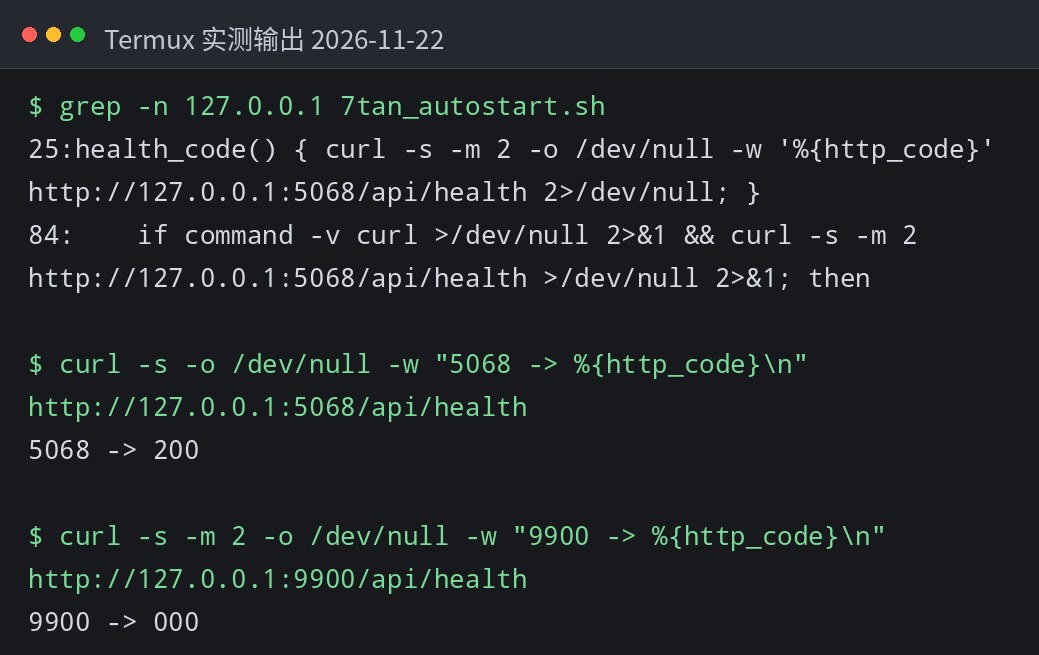
200 和 000 摆在一起,问题就不用解释了:探一个没人监听的端口,当然拿不到 200,于是每一次自启都被判定成「服务挂了」。
第二步:这就是 kill -9 的来源
看一下自启日志就清楚了:
里面是这样的循环:service unresponsive,try CONT(尝试解冻),still unresponsive,force restart (kill -9),spawned python pid=xxxxx,然后 started, health not confirmed in 20s。
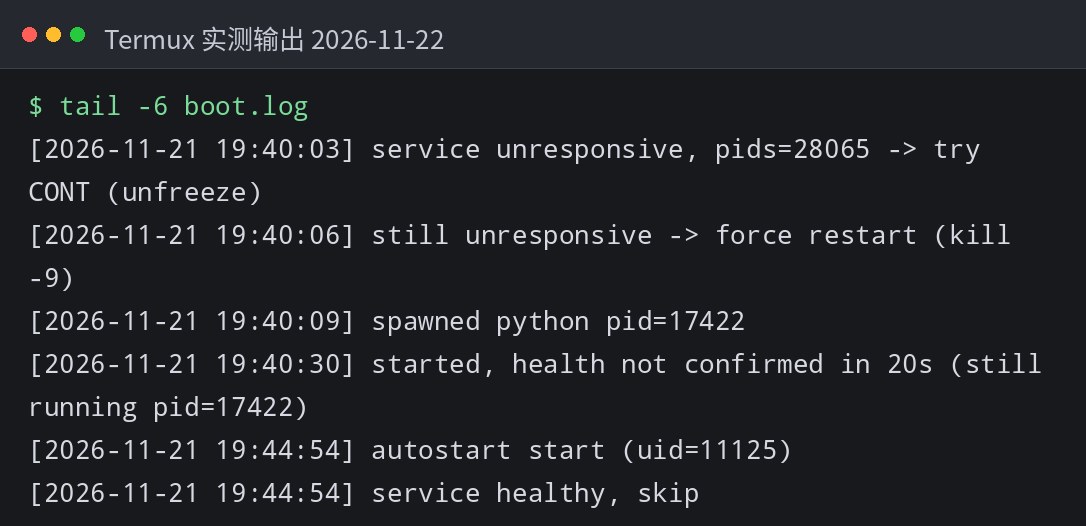
最后那行最说明问题:health not confirmed in 20s。它自己也知道「服务没确认健康」,但下一个周期还是照杀。
而且触发时机很关键:这个自启脚本挂在 .bashrc 里,每打开一次 Termux 就跑一遍。所以症状看起来是「用着用着突然断」,实际上是你每次进 Termux 都在杀它一次。
第三步:改两行,别改一堆
真正要动的只有两处:健康检查那一行,和等待循环里的那一行。把 9900 换成 5068 就行。
改完必须验证「不再杀进程」,而不是只看 curl 通了。做法:先记住 python 的 pid,跑一遍自启脚本,再看 pid 变了没有。
运行后 python pid: 17422
pid 没变,说明它这次没有动手。再看日志新增的那行:
[2026-11-21 19:44:54] service healthy, skip
service healthy, skip。走到这个分支,才算真修好。
一个容易忽略的细节
改之前那行日志里还有一句 service unresponsive,然后 try CONT (unfreeze)。CONT 是给被系统冻住的进程发解冻信号——说明这套逻辑本来是给「锁屏被冻结」准备的。端口写错之后,它把「探不通」也当成「被冻住了」,于是每次都先解冻、再强杀。
所以端口这个错误不只是误判,还会连带一次强杀。这就是为什么症状比单纯的「探活失败」严重得多。
检查你自己的自启脚本
三条命令,一分钟能查完:
curl -s -o /dev/null -w http_code=%{http_code} http://127.0.0.1:5068/api/health
grep -c 9900 ~/7tan_autostart.sh
第一条看探的是哪个端口;第二条确认真实端口回的码;第三条如果还有 9900,除了注释以外都该改掉。